
网站突然不再被搜索或 AI 引用时,先确认目标页面能否被稳定读取,再讨论标题、Schema 和内容改写。连接在返回正文之前就中断,后面的优化尚未进入可以验证的阶段。
一条合格的抓取记录,至少要回答五个问题:连接是否建立、证书是否可信、最终状态码是什么、有没有被准入规则挡住、正文是不是目标内容。 只有“浏览器里看起来正常”,还无法回答这五个问题。
本文是一份技术排障方法。命令使用示例域名,图中的路径是检查顺序,不是任何平台的内部算法,也不代表所有 AI 服务使用相同抓取器。
一、按五层定位,避免把连接故障写成内容问题
建议依次检查连接、TLS、HTTP、准入规则和正文。每一层都保留时间、目标 URL、检查地点与原始错误;上一层没有通过时,不跳到下一层解释原因。
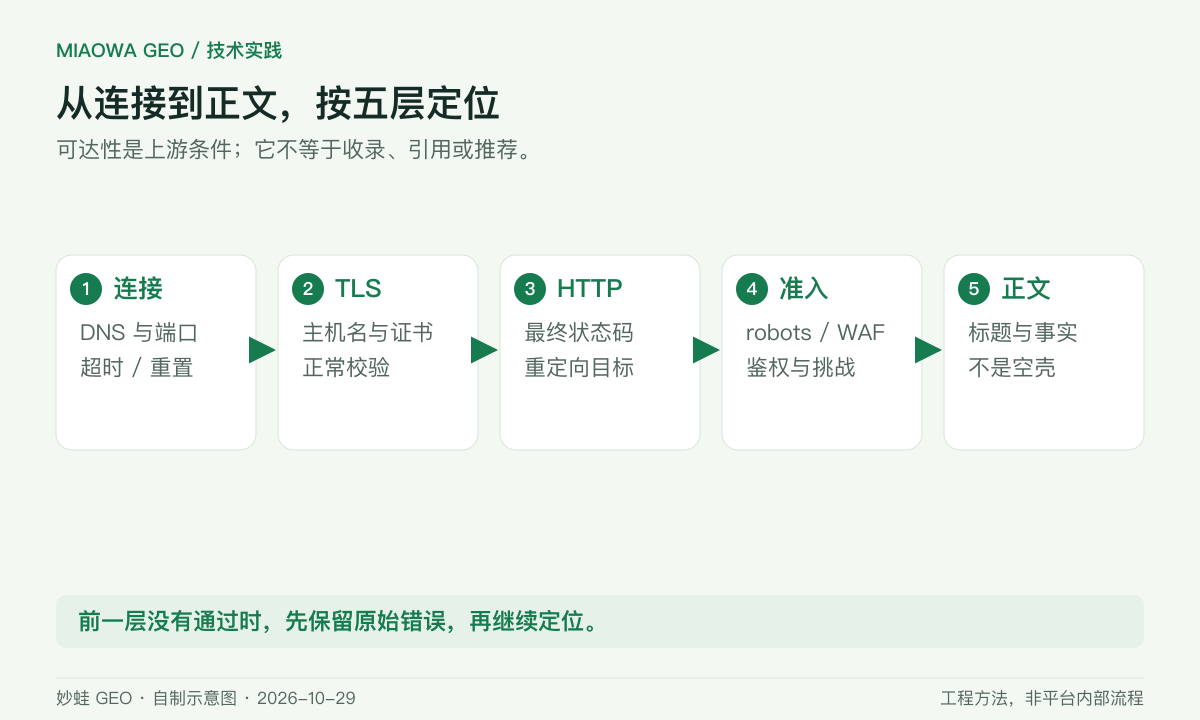
| 层级 | 要确认的事实 | 常见证据 | 还不能据此断言什么 |
|---|---|---|---|
| 连接 | 域名能解析,目标端口能建立连接 | 解析结果、连接超时或重置 | 具体是哪条防火墙规则造成 |
| TLS | 主机名、有效期、证书链校验通过 | 普通 HTTPS 客户端的校验结果 | 页面已收录或已引用 |
| HTTP | 最终响应码与跳转目的地正确 | 响应头、重定向链 | 200 一定是有效正文 |
| 准入 | 请求没有被 robots、鉴权或 WAF 阻断 | robots、规则命中与访问日志 | 某个 UA 就是真实官方爬虫 |
| 正文 | 返回的是可读的目标内容 | 原始 HTML、标题、正文片段 | 内容已经进入某个 AI 的上下文 |
例如,“TLS 握手期间被关闭”和“证书已经过期”是两种不同观察。前者可能连证书都没有拿到,必须继续看服务端日志,不能直接归因为后者。同样,SSH 连接失败只说明管理入口没有连通,不能代替网站 HTTP 健康检查。
二、证书检查必须保留正常校验
检查 HTTPS 时,用与访客相同的公开域名,先发起正常校验的请求。记录失败发生在解析、连接、握手还是接收响应的阶段。
curl --noproxy '*' --connect-timeout 10 --max-time 20 \
  -sS -D headers.txt -o page.html https://example.com/products/model-a
这里的 --noproxy '*' 用于排除本机已配置代理对结果的影响。如果业务本来依赖某条代理或指定网络,应分别记录两种环境,不能把其中一种当作全网结论。
关闭证书校验后拿到 200,只能作为定位应用是否仍响应的诊断证据。恢复验收仍要使用正常校验;否则访客和抓取客户端可能继续遇到安全错误。
如果证书已经续期,接着确认对外监听实际加载的是新证书。文件更新与服务生效是两个事件。建议记录续期任务、部署钩子与公开端口的校验结果,避免只检查磁盘文件。
三、HTTP 状态码要和正文一起看
Google 的官方抓取文档说明,成功响应会进入后续处理流程,但不保证收录。正文如果是空页面或错误提示,200 仍可能表现为软 404。持续的服务端错误则会影响抓取与索引维护。
状态码描述这次响应,正文决定这次究竟交付了什么。 建议按下面的方式分流。
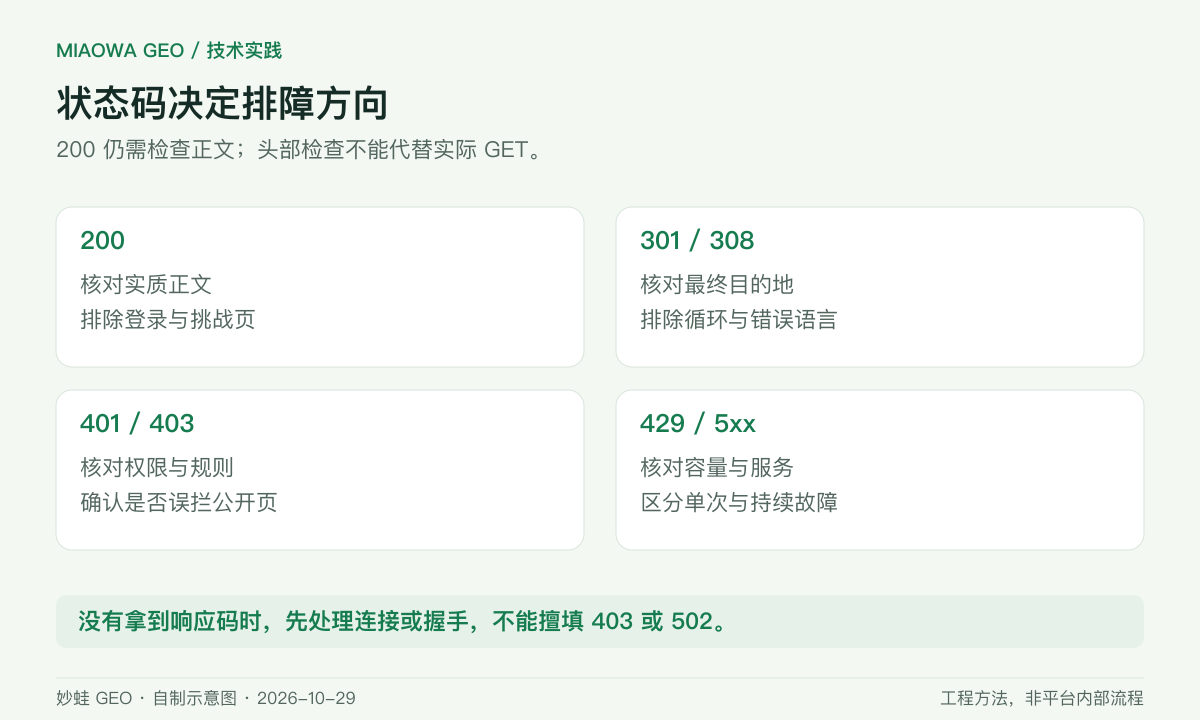
- 没有响应码:检查连接和 TLS。不要在记录里填成 403、502 或“被 AI 拒绝”。
- 200:确认不是验证码、登录表单、空壳页面或“系统繁忙”。抽取一个只有正文才有的句子复核。
- 301、308:查看最终地址是否为预期页面;避免循环、错误语言页或多次跳转。
- 401、403:检查页面是否本来就需要登录,以及 WAF、地域或访问策略是否误拦公开内容。
- 429、5xx:检查限流、上游超时、进程健康与资源用量。区分一次失败与持续故障。
- 404、410:确认是有意删除还是路由错误。已经移走的内容应选择与实际语义相符的处理方式。
HEAD 和 GET 的实现可能不同。面向正文的验收应实际发 GET;只拿首页响应头,也不能代替文章详情页的检查。
四、WAF 与 robots 要查实际命中
robots 是抓取规则声明,WAF 是请求到达过程中的访问控制,两者可能出现“声明允许、实际请求被拦”的组合。反过来,200 也不代表抓取规则允许后续处理。
可以用普通浏览器请求与声明了目标 UA 的请求做差分,比较状态码、正文和挑战页特征。更换 UA 是诊断手段,不是身份验证。 要判断真实官方爬虫,仍需按对应服务商的公开验证方法核对来源,不能仅凭日志里的一段 UA。
公开内容和账户页面也要分开。修复误拦时,应针对需要公开的 URL 与已核验请求调整,保持账户、订单、内部后台和分享边界的既有鉴权。全面放行所有请求会把抓取修复扩大为另一类问题。
如果同一 URL 在两个地区或网络中的结果不同,报告应写“在所测环境中存在差异”,并附各自记录。只有服务端规则与日志能支持更具体的归因时,才填写原因。
五、恢复验收要覆盖三个视角
源站、本地用户网络和外部检查节点分别回答不同问题。源站本机能返回正文,说明应用有响应;公开域名可以正常访问,才说明所测外部链路也已恢复。两项应分别保留。
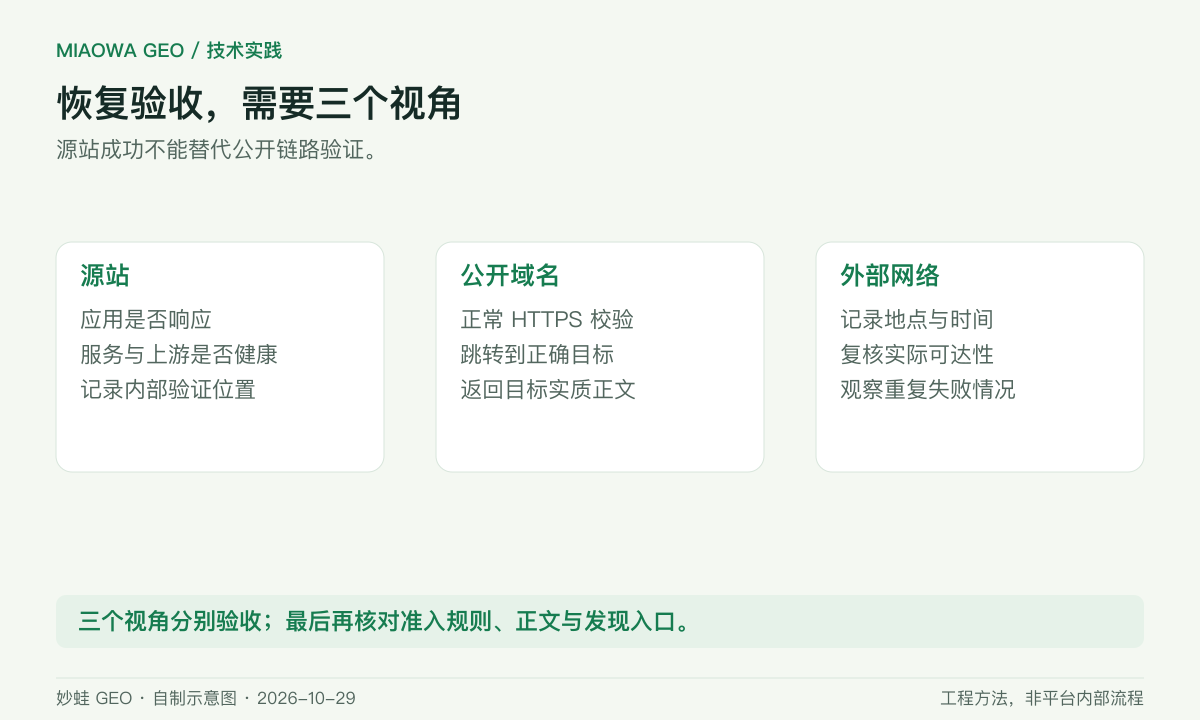
可用下面的顺序验收一次修复:
- 首页与有代表性的文章详情页,正常 HTTPS 校验通过。
- 公开 URL 的最终状态码为预期值,跳转目的地正确。
- 原始 HTML 包含目标标题和实质正文,没有挑战页替换。
- robots、页面 robots 元数据与 HTTP 响应头保持预期。
- Sitemap、RSS 与站内链接可以发现该页面。
- 在已记录的观察窗口继续看失败率,确认没有重复出现相同故障。
不需要把所有请求都写成“全球正常”。记录已验证的位置、网络、时间和 URL 集合,别人才能复查结论。
六、修复后,AI 没立刻更新怎么办
可访问性恢复只是上游条件。重新抓取、索引更新、某次查询是否启用搜索、候选页是否被采用,以及最终有没有引用,是后续不同事件。
因此,恢复报告可以写“所测页面已恢复正常读取”,随后单独检查索引与答案样本。不要把没有立即出现引用视为修复失败,也不要把一个 200 宣布为 GEO 效果提升。
如果团队需要先判断网站的技术准入问题,可以从免费 GEO 检测开始;如果要观察回答中的品牌与引用变化,再结合监测方法建立固定口径。
常见问题
浏览器能打开,为什么还要检查原始 HTML?
浏览器可能有缓存、登录态或脚本补全后的正文。原始响应可以帮助确认匿名抓取方在这次请求中实际收到的内容。不同 AI 产品的执行能力仍要分别验证。
故障发生后要不要立即批量提交所有 URL?
先确认服务恢复且发现入口有效,再按已有站长平台流程提交。提交只是通知,无法补偿持续的连接故障,也不是收录或引用的回执。
相关阅读
- 《先修网站,还是先买 AI 搜索监测?用一次免费检测决定下一步》
- 《AI 爬虫不执行 JavaScript:静态 HTML 可读性的技术验收清单》
- 《一篇技术博客怎样被发现:Sitemap、RSS、IndexNow 与主题内链的四路发布链》
本文技术依据来自 Google Search Central 的 HTTP 状态码、技术要求与 AI 搜索功能文档。分层检查与恢复清单为妙蛙 GEO 的工程方法建议,核对日期为 2026 年 10 月 29 日;不把 Google 的处理规则外推为所有 AI 平台的实现。