
一个回答附上了链接,只能先证明它展示或保存了链接,不能直接证明网页内容支撑了回答。 检索是否命中、证据是否被采用、引用是否正确,是需要分别评估的事件。对消费者 AI 搜索产品做黑盒观察时,这个区分尤其重要。
本文分析妙蛙 GEO 自有项目于 2026 年 9 月 23 日启动的一轮观测:50 道相同问题,覆盖 ChatGPT、Claude、Gemini、Google AI Overview、Microsoft Copilot、Perplexity,共 300 个最终观测。补采保留原题关联,325 次原始尝试不重复计入问题数。这是一份单批观察研究,不是六个平台的能力排行榜,也不是对内部 RAG 算法的逆向证明。
从问题到回答,哪些环节真的被看见了
可把分析分成三层:问题规定任务与采购条件;来源清单提供可检查的网页入口;生成回答提出事实、比较或建议。在可控 RAG 系统中,还能记录检索候选、重排结果和进入上下文的片段;本批消费者网页端样本没有这些内部日志。
因此,我们直接看见的是问题、保存的回答和 URL,代理观察的是来源选择,尚未看见的是完整检索过程和证据吸收。不能因为一个链接出现在清单里,就说模型阅读了全文,更不能说该链接导致了推荐。
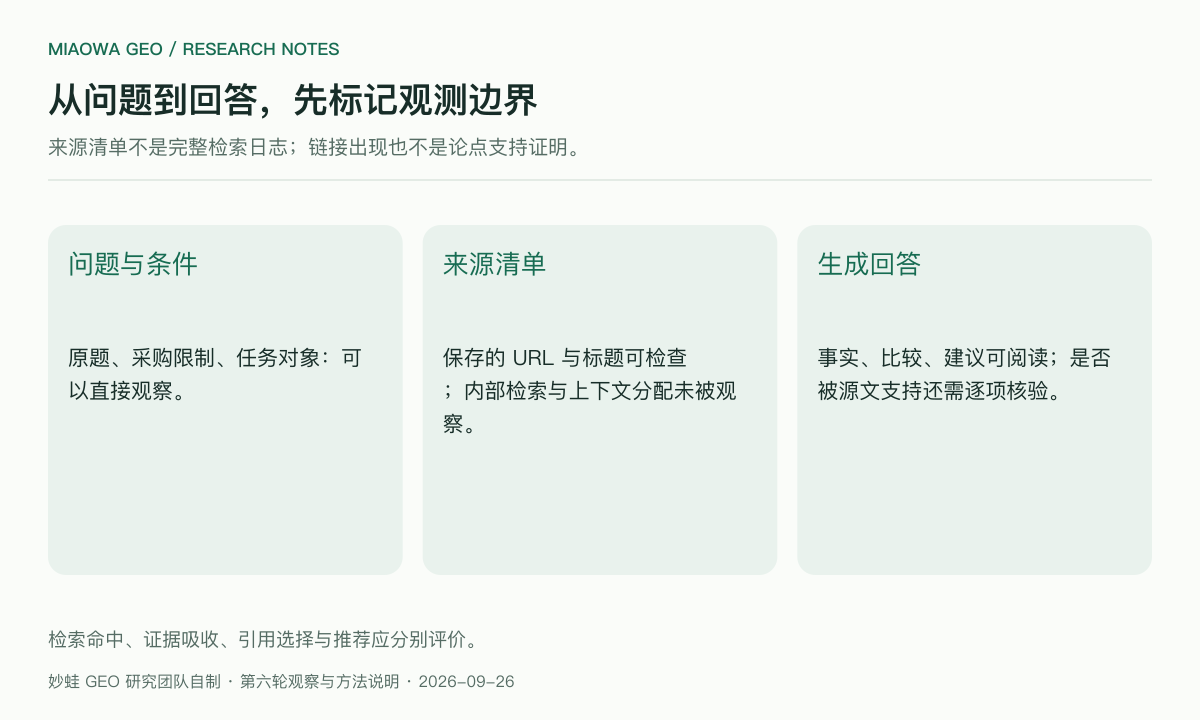
ALCE 研究把引用质量拆成引用召回与引用精确度,分别检查陈述是否得到引用段落支持、引用是否相关。ARES 则分别评估上下文相关性、回答忠实度与回答相关性。这些研究提醒我们:流畅回答、相关文档和有支持的论点不是同一个指标。它们的实验设置不能直接拿来评价本批消费者产品。
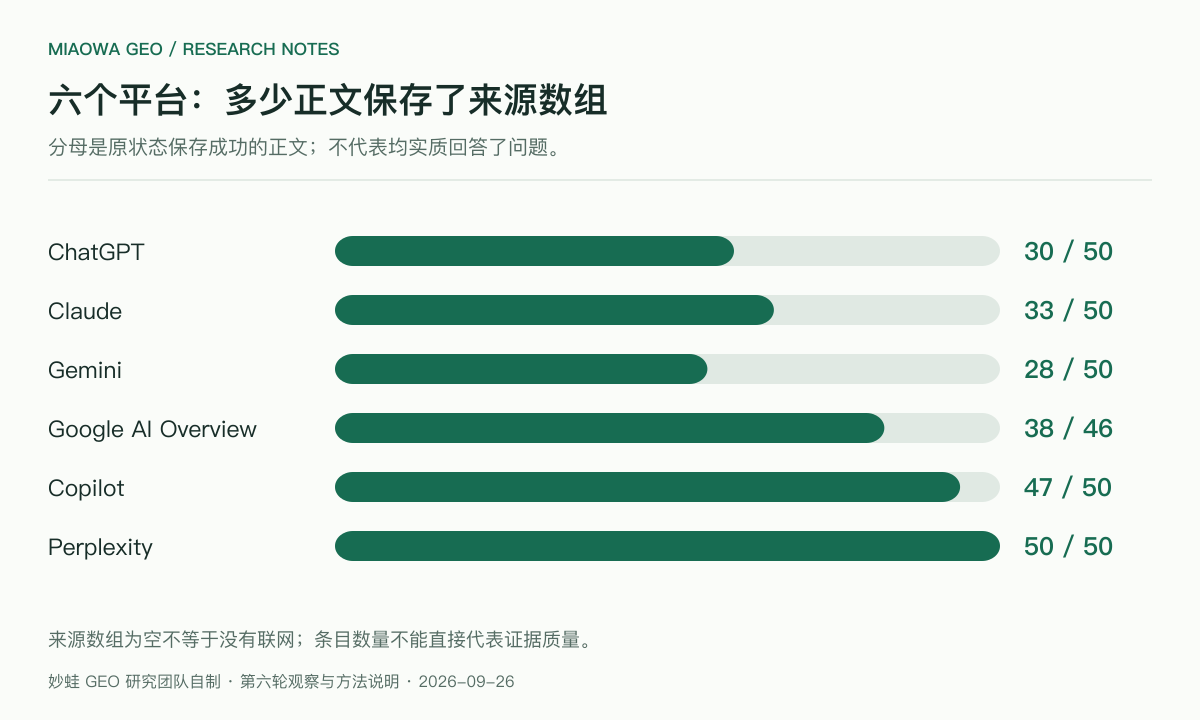
同样 50 道题,来源清单差异很大
本批共有 5,188 个保存的来源条目,规范化后对应 3,408 个 URL、1,270 个域名。在单条回答内去重后,有 5,034 个“回答×URL”,即 154 个条目属于同条回答内的规范化重复。
| 平台 | 有来源数组的记录 / 保存为成功的正文 | 来源条目 | 来源非空时的中位条目数 |
|---|---|---|---|
| ChatGPT | 30 / 50 | 2,626 | 83 |
| Claude | 33 / 50 | 211 | 6 |
| Gemini | 28 / 50 | 194 | 6 |
| Google AI Overview | 38 / 46 | 416 | 10.5 |
| Copilot | 47 / 50 | 301 | 5 |
| Perplexity | 50 / 50 | 1,440 | 29 |
Google AI Overview 另有 4 条未触发记录。这里统计的是采集字段中的来源条目,不是人工确认正确的脚注数。原生来源卡、正文中的官网链接、搜索跳转和重复链接可能混在一起。
以“有哪些 AI 搜索监测服务商”这道发现题为例,ChatGPT 保存 157 个条目,Perplexity 69 个,Google AI Overview 23 个,Copilot 20 个,Claude 12 个,Gemini 没有来源且只给出拒答。前五者的回答都包含不同程度的分类或选型建议,但不能凭链接多少排序正确性。Copilot 在正文中把行业盘点写作依据,另列各产品官网;官网入口和事实依据的作用就不同。
两个容易混淆的反例
第一个反例是“有官网来源,没有品牌提及”。在不点名妙蛙的题中,ChatGPT 有两条、Perplexity 有一条符合这个情况。Perplexity 的采购核验题收录了妙蛙的服务商核验指南,但保存的正文没有妙蛙品牌字符串。文章可以成为方法参考,而文章所属公司没有成为采购对象。
第二个反例是“有品牌提及,没有官网来源”。非点名题中共有四条。它可能通过其他页面介绍品牌,也可能只保存了来源标签而缺少 URL;仅凭当前字段,无法把这几种路径合并成一个解释。
进一步评价“资料究竟支撑哪句话”,需要将回答拆成可验证的论点,记录相邻引用位置,再与源页当时的具体段落核对。只比较答案和页面的词语相似度,仍不足以证明因果采用。
先分清保存成功与回答成功
本批存储状态为 296 条成功正文、4 条未触发。但内容复核发现,Gemini 的 14 条短正文是明确拒答;Google AI Overview 还有一条“暂时无法生成,请稍后重试”的错误提示。这些记录保存完整,不代表已经回答采购问题。
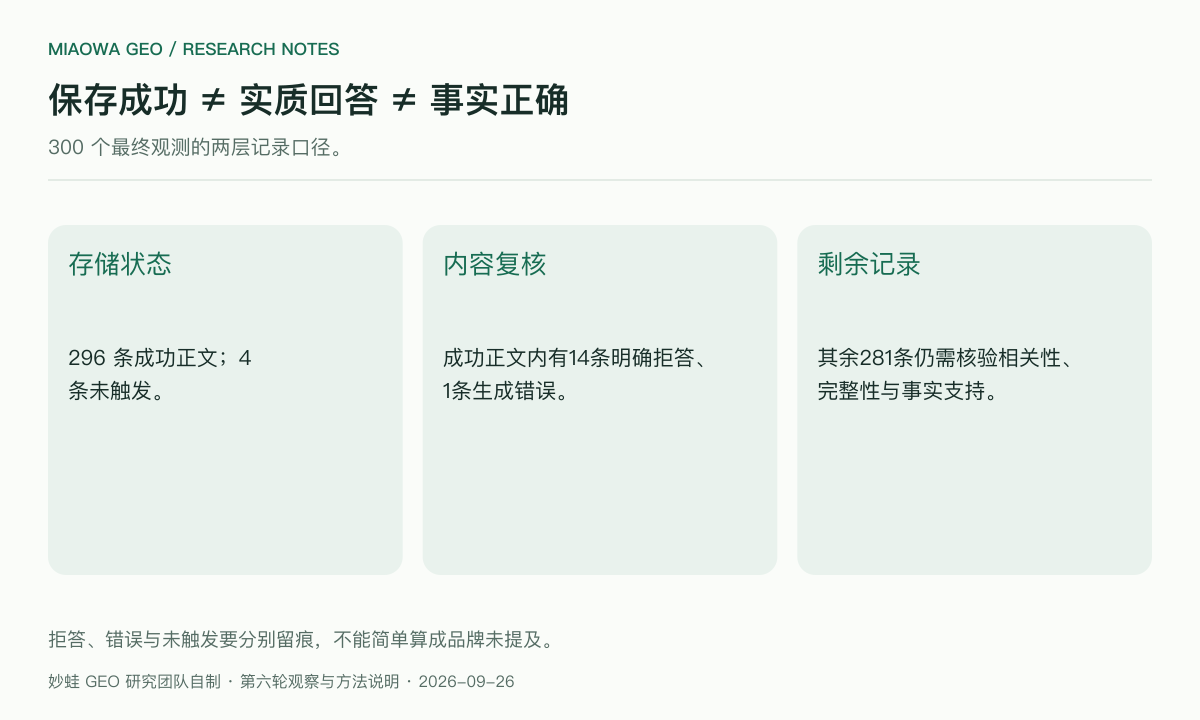
从 296 中扣除上述 15 条,得到 281 条剩余记录,也不能立刻命名为“281 条正确回答”:还有澄清回复和疑似截断内容尚需核对。拒答可以作为真实的观测结果保留,但不应混入“普通回答中未提及品牌”的分母;技术错误又应与拒答分开。
来源本身也需复核。本批发现六个来源条目的域名混入括号、分号或“产品页需咨询”等说明文字;Gemini 的 29 个条目是 Google 搜索入口。不能把这些条目默认当成已验证的正文文档。异常可能在生成、界面链接化或采集解析阶段形成,当前证据不足以定位根因。
一套可执行的引用评估流程
先保留原始问题、正文、URL、时间与采样条件。另建派生字段,记录正文结果类型、完整性、来源角色、URL 解析状态,不覆盖原文。
随后完成三项检查:
- 任务相关性。 回答是否处理了题目的对象、限制与需要的输出?请求补充名单、拒答和错误提示单列。
- 证据支持。 对价格、覆盖平台、周期、公司主体等可验证论点,记录源页版本及支持段落,标为支持、部分支持、冲突或无法确认。
- 引用完整性。 应当有证据的事实陈述是否遗漏来源?链接是否只是推荐访问的官网,还是与陈述相邻的证据?
可控 RAG 还应记录进入上下文的文档与片段;不可控产品应明确这些字段不可观察。没有来源数组不等于未联网,链接相同也不等于不同平台采用了同一段证据。对模型裁判的结果,应抽样人工复核,不能直接把另一模型的评分当作真值。
对 SEO 与 GEO 的实际意义
写内容时,应把实体、事实、适用条件、时间和限制放在读者能看到的正文中;用清晰内链帮助定位原始规则。Google Search Central 对 AI 搜索功能的说明仍强调常规 SEO、可发现的内链、文本内容,以及与可见内容一致的结构化数据,并没有保证某种“特殊 GEO 标记”带来收录。
对本站而言,下一步不是把来源数量做得更大,而是让每条重要结论能回到问题、原文与证据位置。基础概念可结合检索增强与信源选择的入门说明阅读;本轮表现及其公开范围见自有项目观测后台。公开后台的来源数经过隐私过滤,与本文私有原始条目统计不同;后台保存状态与本文语义复核结果也不应混用。
数据与研究边界: 本文数据来自妙蛙 GEO 自有项目第六轮原始观测及 2026 年 9 月 26 日内容复核;方法参考 Princeton 团队的 ALCE(EMNLP 2023)、ARES(NAACL 2024)及 Google Search Central。单次、中文采购问题、自有品牌、补采时间差和字段缺口限制了外推;未观察销售转化,也未证明任何平台内部的因果机制。